
제품
우리 공장의 노하우, 밖으로 보내지 않아도 됩니다.
설비 데이터부터 인공지능 운영까지, 100% 회사 내부 환경에 구성합니다. 접근 권한과 운영 기준을 현장 정책에 맞춰 설계합니다.
경영자·공장장에게
생산 조건과 노하우를 회사 안에 두고 인공지능을 도입.
생산·품질·보전 담당자에게
자료를 외부에 올리지 않고, 맡은 업무에 필요한 정보를 활용.
해결의 흐름
어떤 순서로 해결하나요?
- 01 내부에 보관
외부 반출 제약이 있는 현장에도 적용
- 02 사용 범위
업무에 필요한 범위에서 데이터 활용
- 03 내부에서 활용
회사 정책 안에서 새로운 활용 시작
- 04 운영 확인
도입 이후까지 고려한 운영 계획
상세 안내
적용 범위와 확인할 내용
데이터 위치와 운영 책임을 함께 정합니다
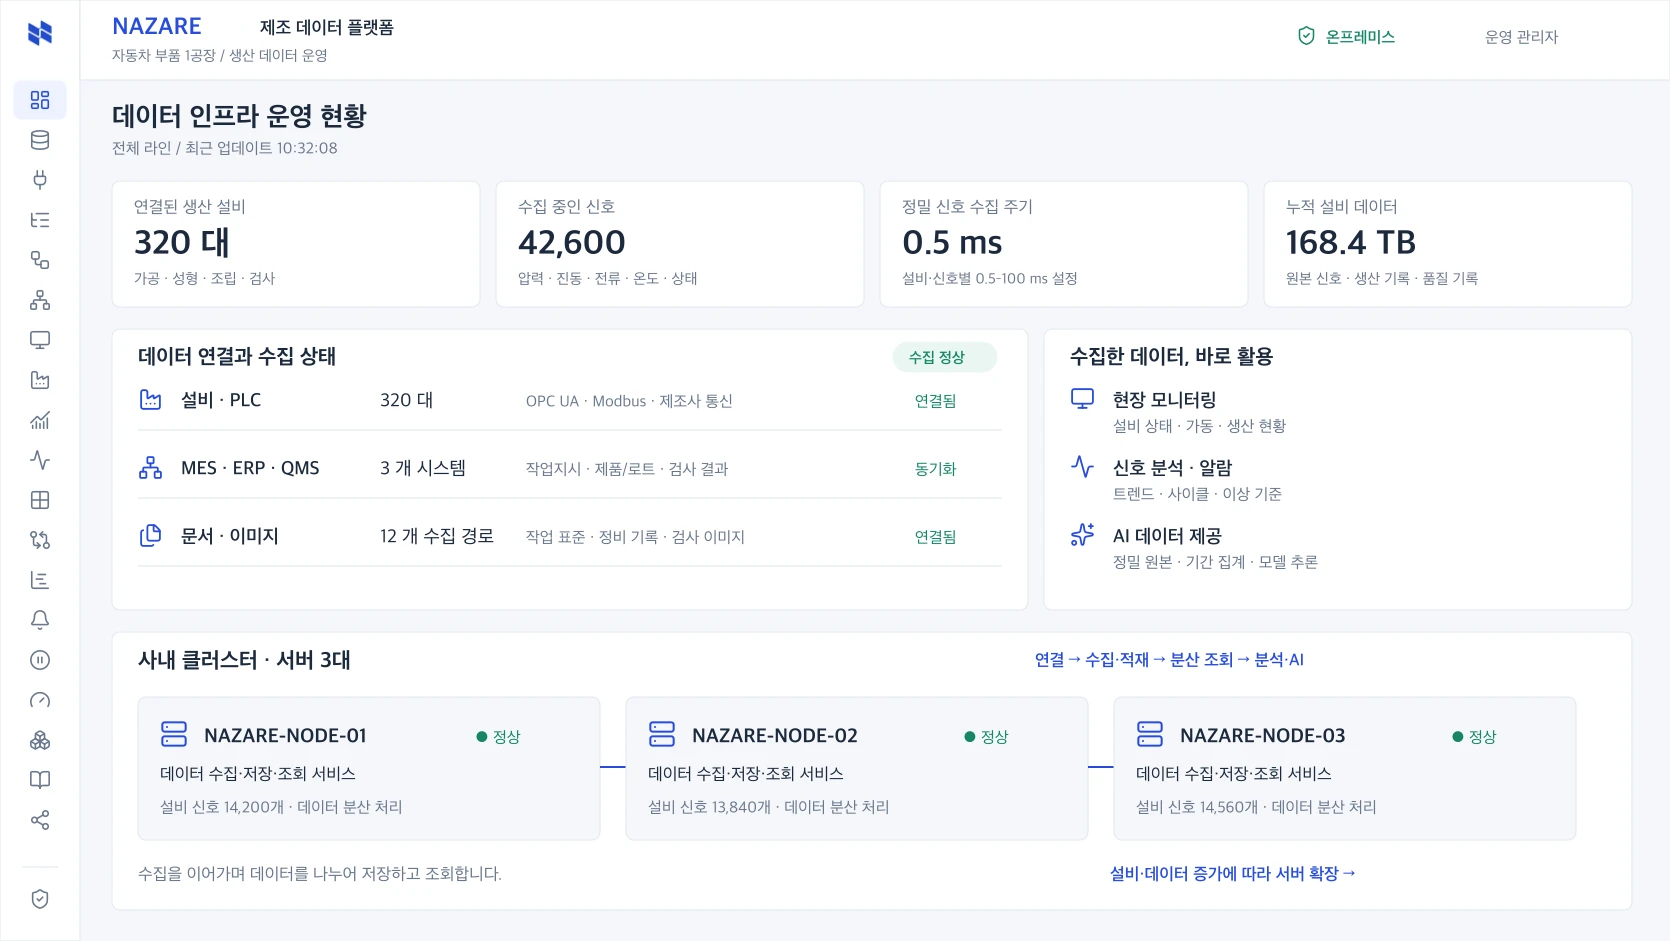
NAZARE는 온프레미스 제조 데이터 플랫폼으로, Kubernetes 기반 컨테이너 구조와 분산 스토리지를 활용합니다. 수집·저장·쿼리·API를 모듈 단위로 운영하고, 컴퓨팅과 스토리지를 분리해 확장하는 구조를 지원합니다.
폐쇄망에서는 외부 인터넷 없이 필요한 서비스가 동작하도록 배포물 반입, 업데이트, 시간 동기화, 인증, 백업, 원격 지원 방식까지 설계해야 합니다. 사내 구축만으로 운영 책임이 사라지는 것은 아니므로 고객 인프라 담당자와 잉클의 역할을 함께 정합니다.
가용성과 운영 자동화
고가용성은 서버 수만으로 결정되지 않습니다. 노드와 디스크 장애, 네트워크 분리, 전원, 백업 복구를 함께 검토합니다. 운영용 클러스터는 3대 이상을 권장하고, 단일 노드는 평가·시연용으로 구분합니다.
컨테이너 기반 배포, 수평 확장, GitOps·IaC 방식의 선언형 배포, 롤링·카나리·블루그린 배포 전략과 자원 모니터링을 지원 범위에 포함합니다. 실제 중단 허용 시간, 복구 목표와 지원 수준은 현장 구성과 계약 기준으로 검증합니다.
보안·인프라 담당자와 확인할 항목
- 설비망과 서비스망 사이의 통신 허용 경로
- 관리자·사용자 인증과 계정 발급·회수 정책
- 외부 모델 API 사용 여부와 사내 LLM 서빙 필요성
- 업데이트 파일 반입과 검증, 적용 가능한 점검 시간
- 백업 위치·주기·복원 시험과 장애 대응 연락 체계
- 서버·스토리지·네트워크 장비 조달과 유지보수 책임
AI 모델 운영에는 모델 크기와 동시 사용량에 따른 별도 CPU·GPU 산정이 필요합니다. 데이터 플랫폼 서버 권장 사양을 모든 LLM의 권장 사양으로 해석하지 않습니다.
함께 시작하기
지금 가장 바꾸고 싶은 일부터 이야기해 주세요.
현재 설비와 데이터 환경, 해결하고 싶은 과제를 알려주시면 연결부터 운영까지 필요한 범위를 함께 검토합니다.