
NAZARE
Infrastructure de données industrielles sur trois serveurs
Exploiter ensemble connexions, ingestion, stockage et requêtes dans un cluster sur site.
Découvrir le produit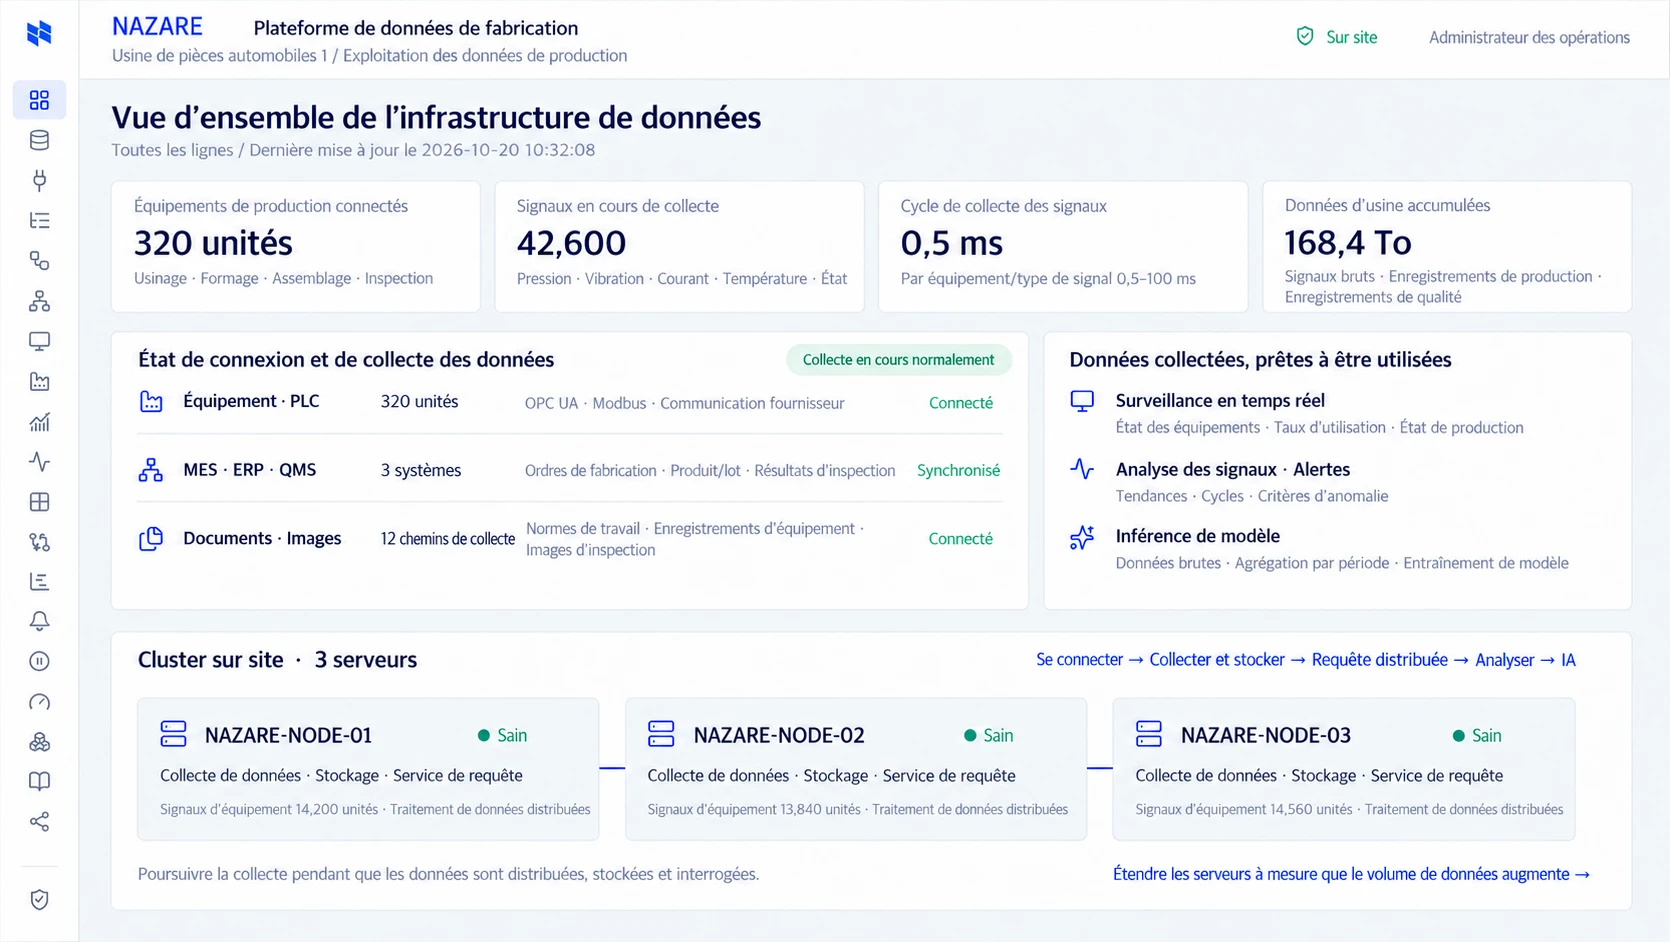
Ressources
Concevoir les flux de données et responsabilités selon l’échantillonnage, la rétention, les requêtes et les charges IA.
L’approche
Adapté aux sites qui limitent la sortie des données
Utiliser les données dans le périmètre de chaque tâche
Lancer de nouveaux usages dans le cadre des politiques de l’entreprise
Planifier au-delà du premier déploiement
NAZARE
Exploiter ensemble connexions, ingestion, stockage et requêtes dans un cluster sur site.
Découvrir le produitDétails
Cartographier génération, ingestion, préparation, stockage, requêtes, entrées des modèles et retrait. Attribuer latence, reprise et responsabilités à chaque étape. La rétention brute et l’historique des modifications permettent des analyses reproductibles au-delà du tableau de bord.
Les alarmes en direct nécessitent des signaux frais ; les requêtes historiques sélectionnent les fichiers et colonnes pertinents. Estimer volume, rétention et concurrence par voie. Inclure échantillonnage, taille des valeurs, réplication, sauvegarde et agrégation, pas seulement le nombre de tags.
Convenir des identités, types, fuseaux horaires, unités, cadences et erreurs entre équipements, MES, qualité et plateforme. Appliquer la même rigueur aux requêtes destinées aux partenaires.
Séparer les droits de lecture et d’action, en documentant entrées, sorties, échecs et périmètre d’approbation des outils pour NAVIS.
Observer infrastructure, qualité, pipelines, requêtes et service des modèles. Valider la restauration autant que la création des sauvegardes. Inclure isolement des locataires, accès, changements de version et responsabilités de support dans le périmètre de déploiement.
Commencer ensemble
Présentez-nous vos équipements, données et priorités pour examiner le parcours de la connexion à l’exploitation.